Overview
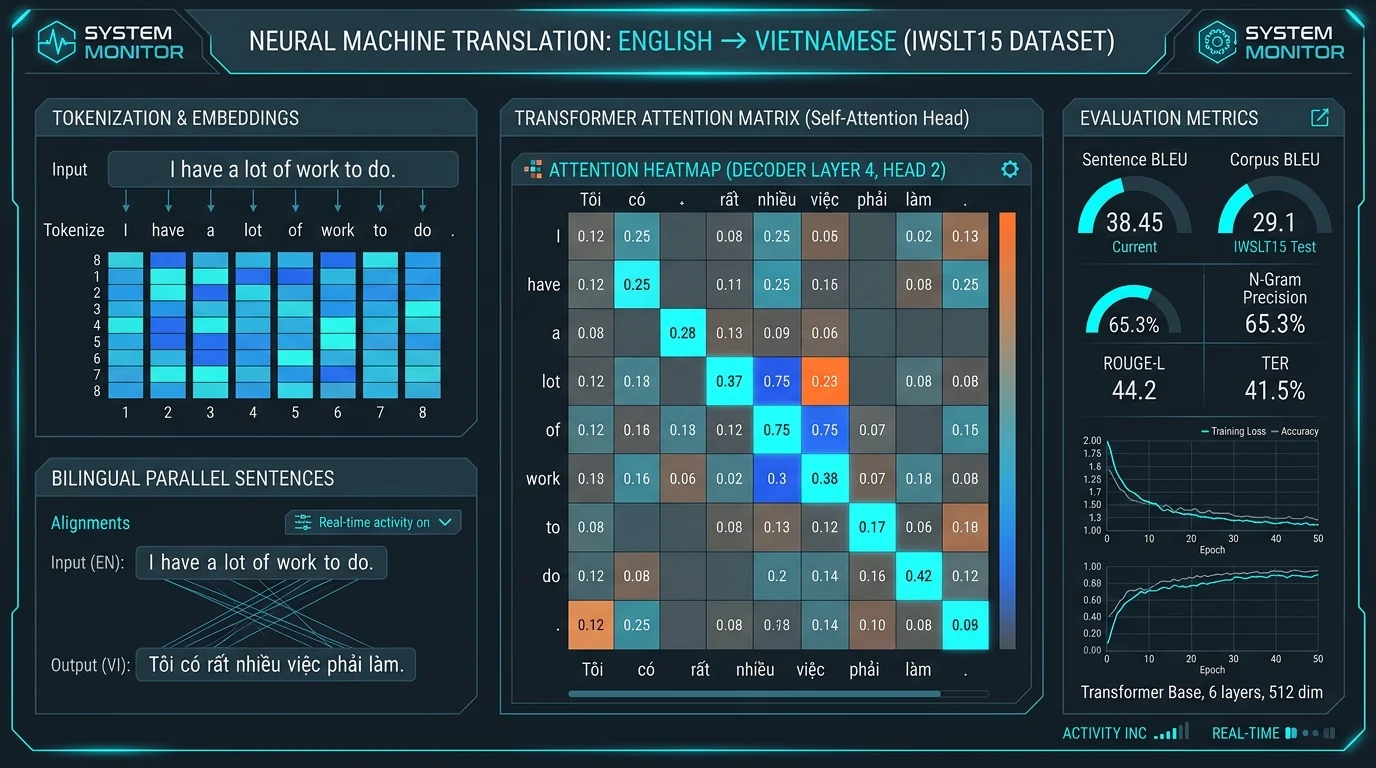
Comprehensive Natural Language Processing (NLP) project comprising two modules: (1) RLHF & PPO exploration (CartPole baseline & causal LLM fine-tuning using Hugging Face TRL); (2) Comprehensive EN↔VI Machine Translation benchmark comparing models trained from scratch vs pretrained models.
System Architecture
Diverse architectural suite: Custom Transformer Seq2Seq (Encoder-Decoder) from scratch, small GPT with SentencePiece tokenizer; Pretrained models include fine-tuned GPT-2 with [EN]/[VI] tokens and Helsinki-NLP MarianMT.
Data & Database
Parallel English-Vietnamese bilingual datasets (IWSLT'15 en-vi): Text cleaning, sentence length filtering, custom train/val/test splits, and quantitative translation evaluation via SacreBLEU and ROUGE.
Key Challenges & Technical Solutions
- 01
1. RLHF Alignment via PPO with TRL for Causal LMs:
Configured Proximal Policy Optimization (PPO) using Hugging Face TRL and Accelerate, fine-tuning causal language models with advantage clipping and policy updates.
- 02
2. Custom Subword Tokenization Eradicating OOV Deficiencies:
Trained dedicated SentencePiece subword tokenizers for custom GPT models, resolving out-of-vocabulary challenges across bilingual vocabulary distributions.
- 03
3. Empirical Benchmarking (From-Scratch vs Pretrained):
Benchmarked scratch Transformer models against pretrained Helsinki-NLP MarianMT models on IWSLT'15, tracking SacreBLEU convergence trajectories.