Tháng 8, 2026 - Hiện tại • Hệ Thống Trích Xuất & Nhận Dạng Tài Liệu Thông Minh
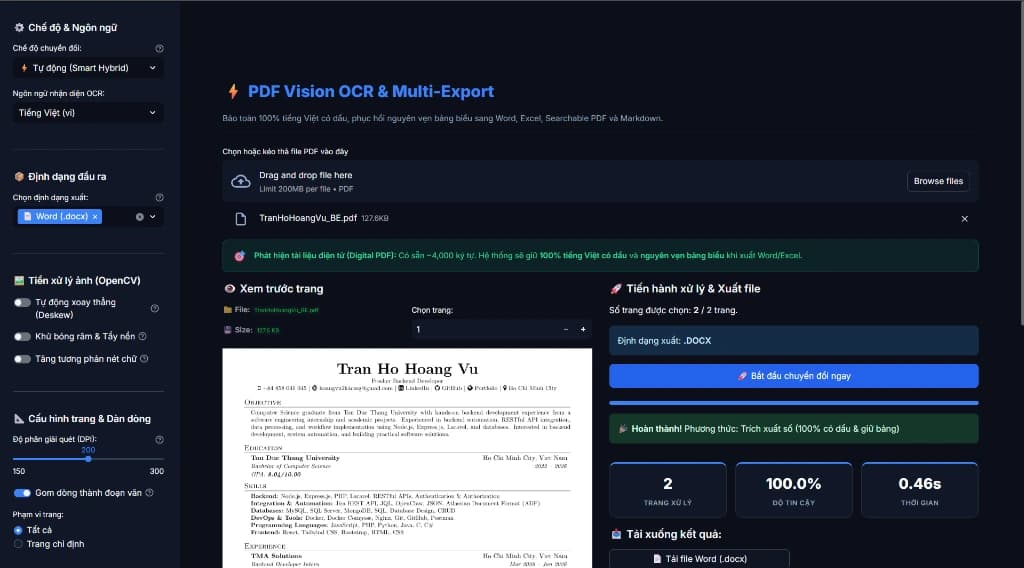
Tổng quan
PDF Vision OCR là ứng dụng nhận diện ký tự quang học thông minh chuyên xử lý tài liệu PDF tiếng Việt (PDF scan, chụp nghiêng từ điện thoại và tài liệu số hóa). Hệ thống bảo toàn 100% tiếng Việt có dấu và cấu trúc bảng biểu, xuất đa định dạng (DOCX, XLSX, Searchable PDF, Markdown, Master ZIP) cùng hai giao diện song hành: Streamlit Web UI và FastAPI RESTful API.
Kiến trúc Hệ thống
Kiến trúc module hóa tách bạch giữa Image Preprocessor, OCR Engine Orchestrator, Exporters và Dual Interface. Render trực tiếp PDF sang ảnh trong bộ nhớ RAM qua PyMuPDF (`fitz`), loại bỏ hoàn toàn phụ thuộc vào Poppler ngoài và tối ưu hóa container Docker nhẹ.
Dữ liệu & Cơ sở dữ liệu
Pipeline tiền xử lý ảnh OpenCV: Auto-Deskew nắn thẳng góc nghiêng (Hough Lines / minAreaRect), khử bóng râm chiếu sáng qua hình thái học ảnh và tăng cường tương phản nét chữ CLAHE cục bộ.
Thách thức Kỹ thuật & Giải pháp cốt lõi
- 01
1. Bảo toàn toàn vẹn dấu tiếng Việt và cấu trúc bảng biểu phức tạp:
Tự động phát hiện Digital PDF để trích xuất text layer gốc; với tài liệu scan, kết hợp PaddleOCR tiếng Việt với thuật toán nhóm bounding box theo tọa độ để tái tạo bảng trên Word và Excel.
- 02
2. Nhận diện chữ viết tay mờ và tài liệu scan chất lượng kém:
Tích hợp mô hình Google Gemini 2.5 Flash Vision API với structured prompt trích xuất văn bản; thiết lập cơ chế tự động fallback về PaddleOCR khi gặp sự cố mạng hoặc quota.
- 03
3. Kiến trúc Dual-Interface & Container hóa Docker đa chế độ:
Xây dựng Dockerfile đa mục đích kết hợp entrypoint script điều phối linh hoạt qua biến môi trường APP_MODE (web, api, full) và Docker Compose profiles.