Tổng quan
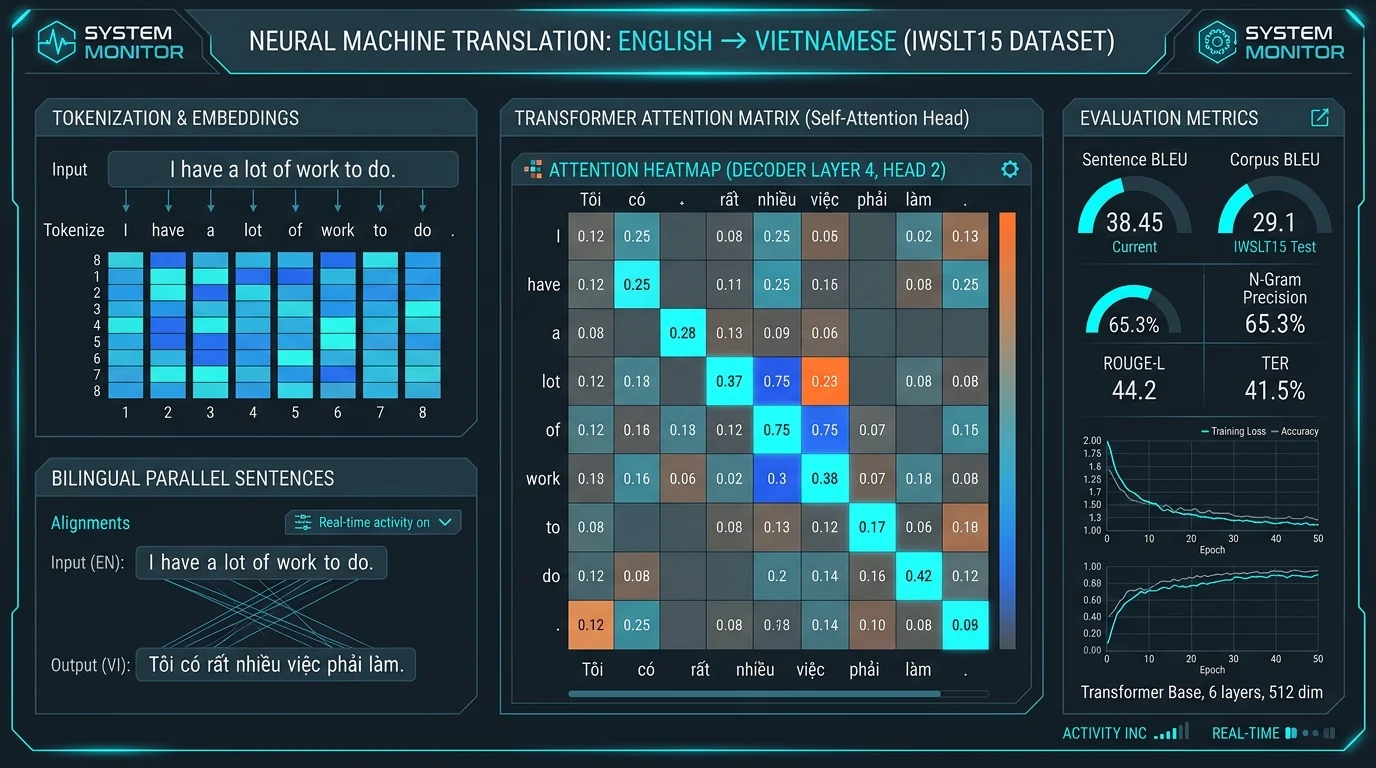
Đồ án Xử lý Ngôn ngữ Tự nhiên (NLP) gồm 2 phần chuyên sâu: (1) Khảo sát Reinforcement Learning from Human Feedback (RLHF): cài đặt PPO trên CartPole-v1 và PPO tinh chỉnh mô hình ngôn ngữ nhân quả (Causal LM) với thư viện Hugging Face TRL; (2) So sánh toàn diện mô hình dịch máy Anh - Việt (EN↔VI) giữa phương pháp tự huấn luyện từ đầu (no-pretrain) và mô hình pretrained.
Kiến trúc Hệ thống
Mô hình đa dạng: Transformer seq2seq tự xây dựng từ đầu, GPT kiến trúc nhỏ kèm SentencePiece tokenizer; Mô hình Pretrained gồm GPT-2 tinh chỉnh với special tokens ([EN], [VI]) và MarianMT (Helsinki-NLP) tinh chỉnh chuyên sâu.
Dữ liệu & Cơ sở dữ liệu
Ngữ liệu song ngữ tiếng Anh - tiếng Việt (IWSLT'15 EN-VI): Làm sạch ký tự đặc biệt, lọc giới hạn độ dài câu, phân tách train/validation/test và đánh giá định lượng bằng SacreBLEU và ROUGE.
Thách thức Kỹ thuật & Giải pháp cốt lõi
- 01
1. Triển khai thuật toán PPO phục vụ căn chỉnh RLHF cho Causal LM:
Triển khai thuật toán Proximal Policy Optimization (PPO) kết hợp thư viện TRL, thiết lập policy/value network, advantage estimation và hàm mục tiêu clipping để điều chỉnh hành vi sinh văn bản của causal LM.
- 02
2. Giải quyết hiện tượng Out-of-Vocabulary (OOV) khi tự huấn luyện từ đầu:
Huấn luyện tokenizer riêng biệt bằng SentencePiece cho mô hình GPT tự xây dựng, xử lý hiệu quả hiện tượng Out-of-Vocabulary (OOV) trên dữ liệu song ngữ Anh - Việt.
- 03
3. Đo lường đối chiếu công bằng giữa mô hình Scratch và Pretrained:
Tiến hành đánh giá đối chiếu giữa Transformer tự huấn luyện và MarianMT pretrained (Helsinki-NLP) trên tập IWSLT15, đo lường chính xác bằng thang đo tiêu chuẩn SacreBLEU.